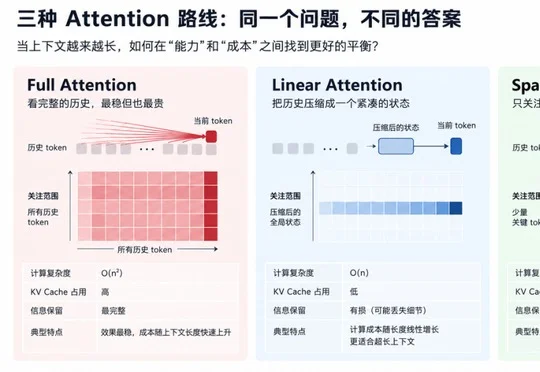
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?
Kimi 和 DeepSeek,为什么出现在同一张模型架构图里?GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
来自主题: AI技术研报
6523 点击 2026-09-25 10:11

 搜索
GLM-5.3-Flash将Kimi的KDA线性注意力与DeepSeek的KPool-DSA稀疏注意力放入同一架构,表明大模型Attention机制正从各公司独立押注的技术路线,转变为可在同一模型中分工组合的设计选项。
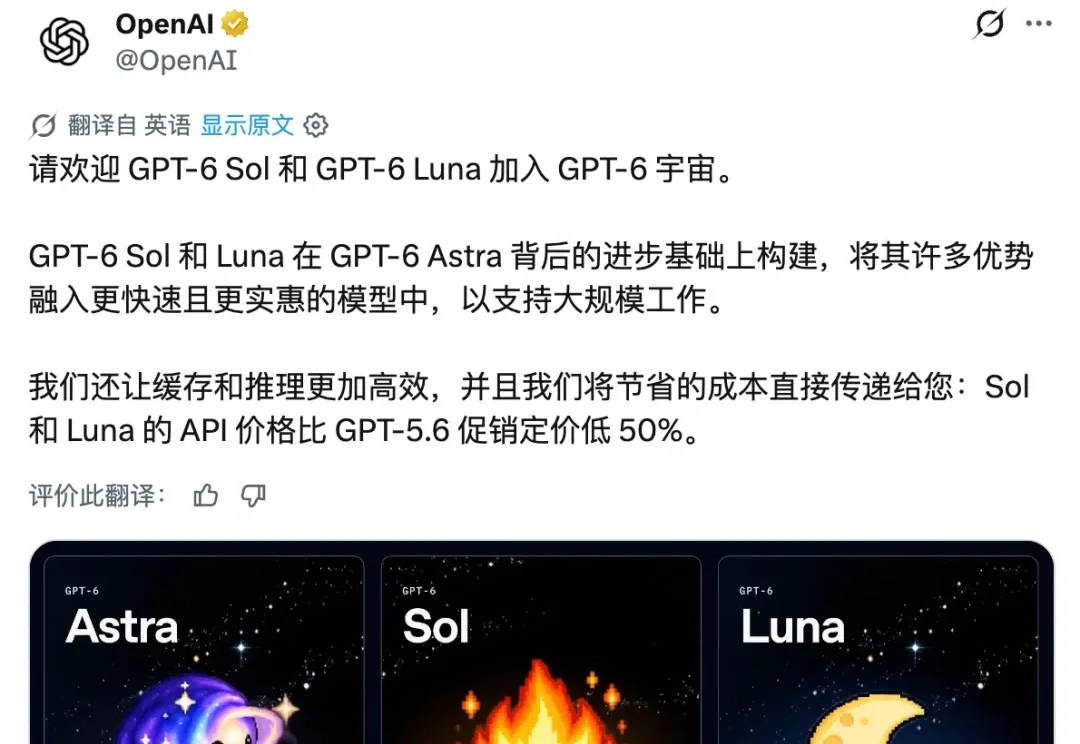
DeepSeek 快醒醒,ChatGPT 要打到家门口了。
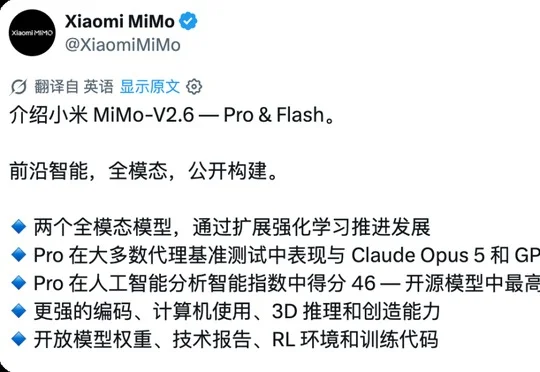
小米正式发布并开源 MiMo-V2.6 系列模型,罗福莉称其背后的研究创新和工程难度超过 DeepSeek R1,在 Artificial Analysis Intelligence Index v4.3 中以 46.32 分成为当前得分最高的开源模型,价格仅为海外同级模型的 1/20 至 1/60。
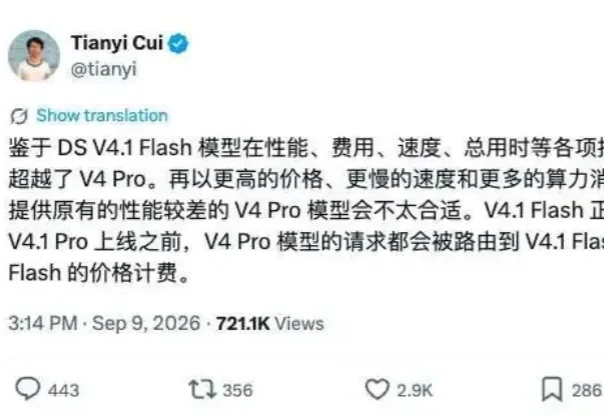
崔添翼最近在 X 上刷屏有点多。9 月 9 日,这位今年 3 月加入 DeepSeek、负责 Agent 运行和评估基础设施的 Harness 团队成员发推称,V4.1 Flash 在性能、费用、速度和总用时等方面全面超过 V4 Pro,因此 V4.1 Flash 上线后、V4.1 Pro 上线前,所有发往 V4 Pro 的请求都会被路由到 V4.1 Flash,按 Flash 的价格计费。
DeepSeek 突然上线限时内测模型 DeepSeek V4.1 Flash,采用新模型结构并原生支持多模态,在生成速度、使用成本和中文长文写作等实测中表现优于以往版本,DeepSeek 期望其在保持 Flash 速度与价格优势的同时,能力向 V4 Pro 靠拢。
距离 DeepSeek Harness 开源已经有一段时间,「Everything is a Plugin」的口号也已经在各种领域开枝散叶,坊间涌现出了特别多的插件和社区。十几天后的现在,GitHub 上【 dsh-plugin 】标签下有一万多个仓库。我们花了几天时间,把这一万多个仓库拆开数了一遍
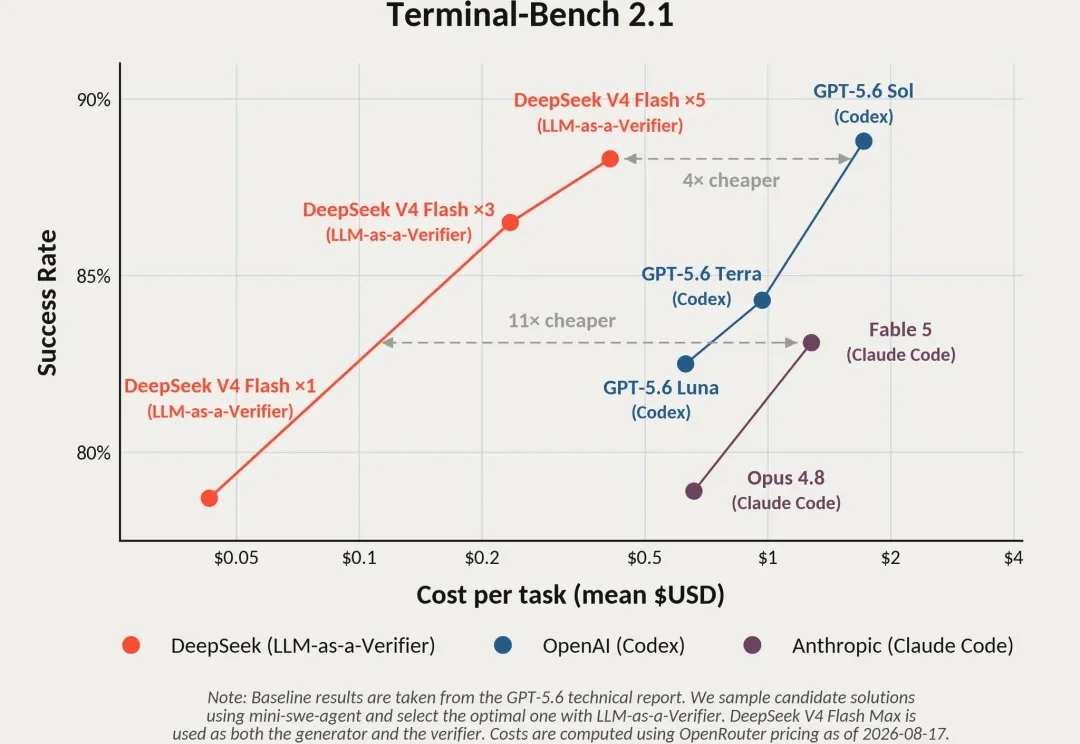
随着开源模型能力不断提升,它们已经能够以极低的成本生成多个高质量候选方案,并进一步利用模型自身对这些结果进行验证、打分和筛选。斯坦福团队最新实验发现,使用 DeepSeek V4 Flash + LLM-as-a-Verifier 进行「自验证」,可以在 Terminal-Bench 2.1 上超越 Claude Fable 5,同时整体成本低约 11 倍。
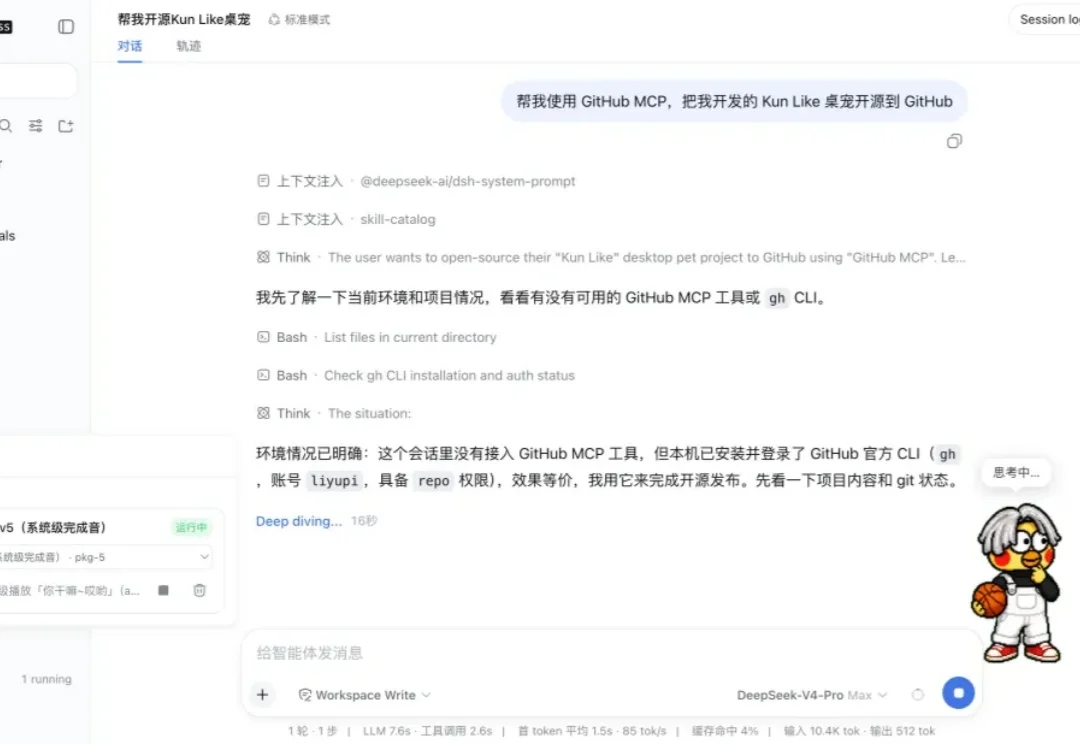
最近 DeepSeek Harness(DSH)真是太火了!之前我发过 《首发实测 + 入门教程》 教大家如何安装使用,还盘点过 《16 个超火的 DSH 插件》。
“你以为你买的是 DeepSeek Flash,实际上可能是个 1.5 bit 的 DeepSeek,或者里面掺了 Opus 用于训练。”这是 Pi 核心贡献者 Armin Ronacher 的一个比喻。他形容现在的 token 市场像一种成分不明的商品——量化程度、实际版本、是否掺了别的东西、计费方式,全是黑洞。
AI行业观察 DeepSeek 峰值涨价五倍之后,有人把 AI 员工塞进了你的电脑 "水龙头和水井的账,每个人心里都有自己的算法。但至少从今天开始,你多了一个选项:把 AI 员工领回家住。" 先跟你报